30 de maio de 2025
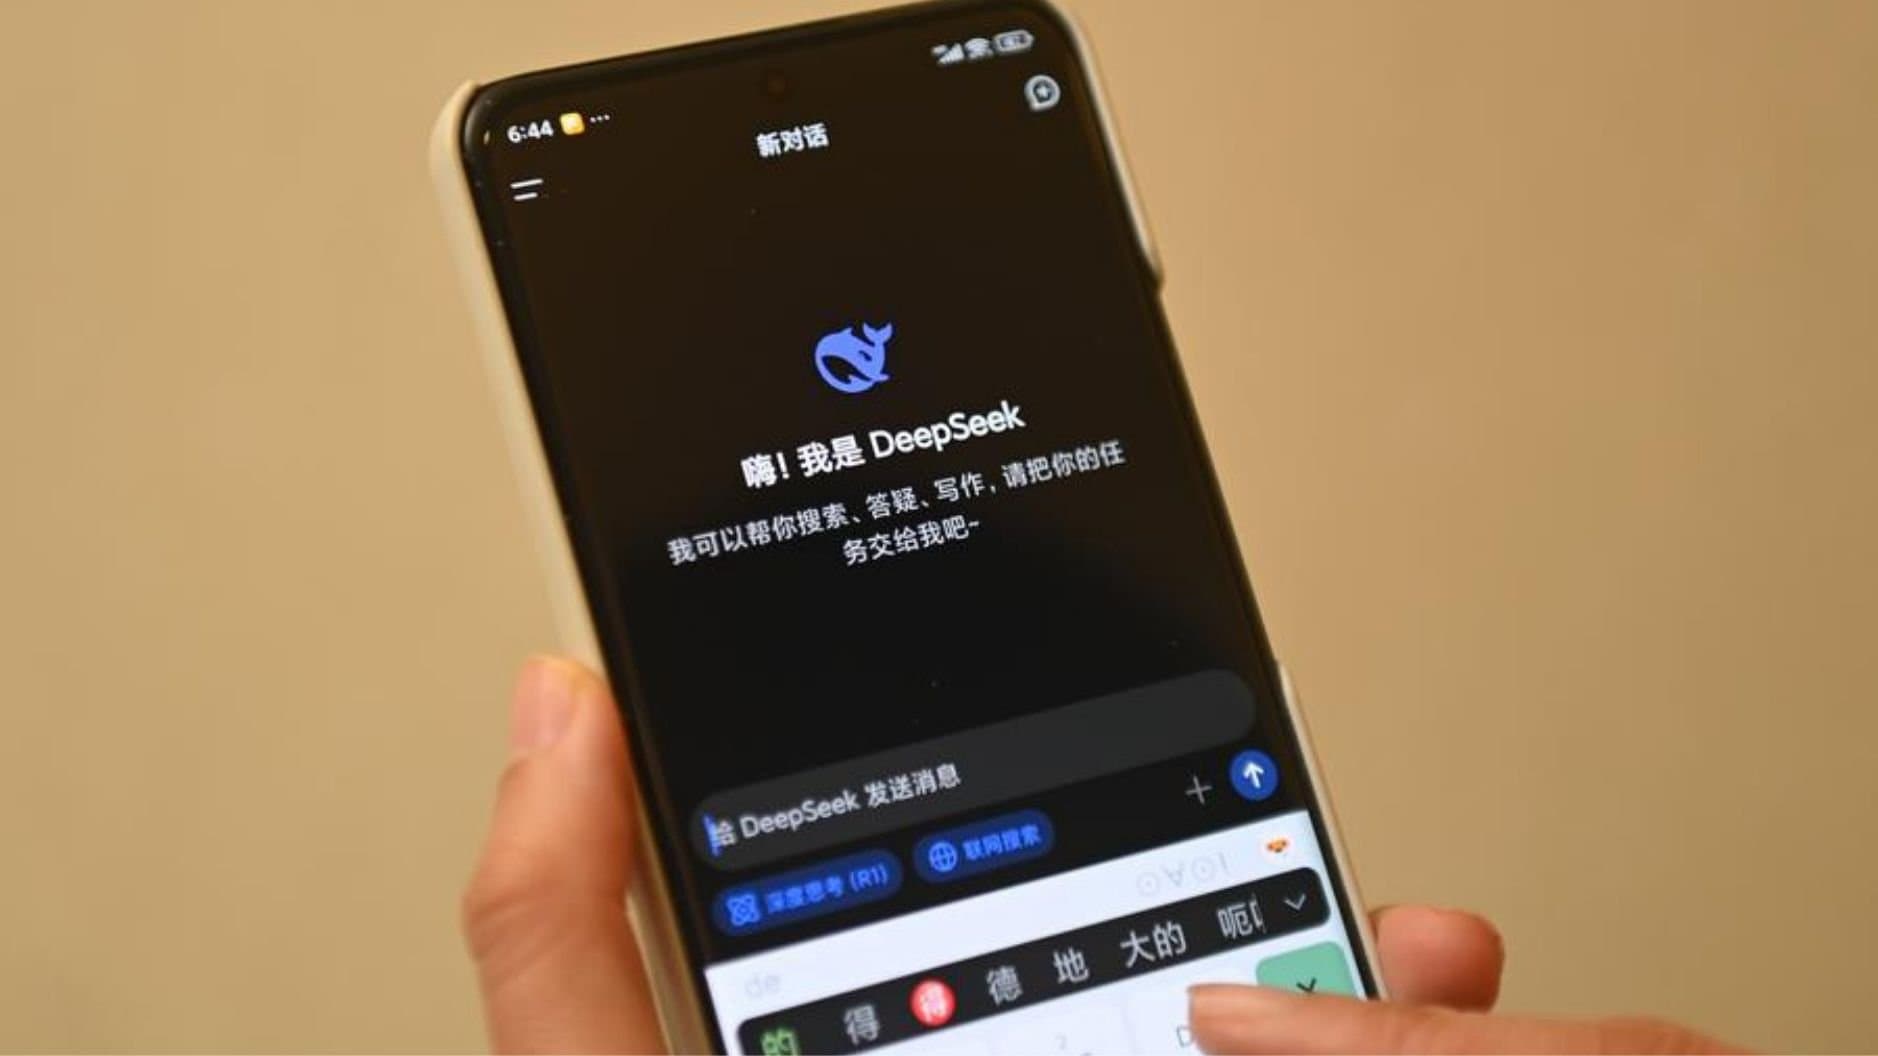
A indústria de inteligência artificial acompanha os avanços da DeepSeek, que lançou, em 28 de maio, a versão R1-0528. A nova atualização elevou o desempenho do modelo em tarefas de programação, gerando até 728 linhas de código para desenvolver um aplicativo de animação 3D com efeitos de partículas. O resultado é comparável ao do Claude 4, da Anthropic. O DeepSeek R1, lançado em janeiro de 2025 por uma equipe chinesa, já havia chamado atenção por atingir desempenho próximo ao modelo o1 da OpenAI com um orçamento de treinamento de US$6 milhões, valor muito inferior aos US$500 milhões investidos pela concorrente americana. Desde então, em vez de lançar o esperado R2, a empresa optou por evoluir o modelo por meio de atualizações incrementais. Avanços técnicos e limitações A versão R1-0528 incorporou mecanismos de auto verificação para melhorar a precisão em respostas matemáticas e factuais. No benchmark Extended NYT Connections, a pontuação subiu de 38,6 para 49,8, alta de quase 30%. Esse resultado é atribuído ao algoritmo GRPO (Group Relative Policy Optimization), que substituiu o método PPO tradicional. O GRPO compara amostras em grupos, dispensa redes de valor independentes e reduz o uso de memória em 40%, além de aumentar a eficiência de treinamento em 2,3 vezes. Apesar disso, a atualização não resolveu limitações em suporte multilíngue e compreensão multimodal. O modelo ainda precisa traduzir perguntas em alemão para chinês ou inglês antes de processar. Também apresenta desempenho inferior em chamadas de funções complexas e simulações de papéis, áreas em que modelos concorrentes mantêm vantagem. Outra mudança significativa foi a adoção de cadeias de raciocínio mais longas. Em um teste com o problema "estimar π/7", o modelo levou 148 segundos para apresentar uma resposta, detalhando métodos como a série de Taylor. Esse tipo de inferência gradual melhora a capacidade de autocorreção, útil em linguagens como Zig, mas aumenta o tempo de resposta, um ponto crítico em interações em tempo real. Desempenho em produção de conteúdo O DeepSeek R1-0528 também melhorou em tarefas de escrita. As respostas agora seguem um padrão estruturado, com análise do problema, dedução e validação. Em perguntas históricas, o modelo apresenta mais contexto e múltiplas perspectivas. Além disso, a mistura de idiomas foi praticamente eliminada após reforço com recompensas de formatação. A evolução técnica veio com custos. Resolver uma questão complexa de matemática levou 83 segundos; responder a uma pergunta da competição AIME exigiu 213 segundos. Em testes com poucos exemplos (Few-Shot), o modelo foi até sete vezes mais lento que concorrentes que não usam inferência profunda. Parte dessa lentidão está ligada à arquitetura MoE (Mixture of Experts), que ativa apenas 37 bilhões de parâmetros por inferência de um total de 671 bilhões. Essa escolha reduz custos, mas limita o cálculo paralelo. O preço da API da DeepSeek segue competitivo: US$0,55 por milhão de tokens de entrada e US$2,19 por milhão de tokens de saída, 3,7% do valor cobrado pelo OpenAI o1. Para aplicações que exigem interatividade em tempo real, no entanto, a latência continua sendo um obstáculo. Interações contínuas mudam paradigma de desenvolvimento A estratégia da DeepSeek sinaliza uma mudança no desenvolvimento de modelos de IA. Em vez de grandes saltos, a empresa aposta em melhorias contínuas com foco em problemas específicos. A abordagem reduz riscos e permite resposta rápida ao feedback da comunidade, como o suporte ao framework three.js. A licença open source MIT e o modelo destilado facilitam a integração por parte de empresas e permitem a execução até em GPUs convencionais. Após o lançamento da versão R1-0528, o volume de chamadas à API cresceu a ponto de causar interrupções temporárias no serviço. Os ganhos acumulados das atualizações elevaram o desempenho do modelo. No Codeforces, o ELO do R1 passou de 1890 para 2029, superando 96% dos programadores humanos. Em design de front-end, a qualidade alcançada já dificulta a distinção para quem não é especialista. Fonte: 36kr.com
30 de janeiro de 2025
A gigante chinesa de tecnologia Alibaba lançou nesta quarta-feira (29) uma nova versão de seu modelo de inteligência artificial Qwen 2.5, afirmando que ele supera o altamente aclamado DeepSeek-V3. O modelo, denominado Qwen 2.5-Max, foi lançado no primeiro dia do Ano Novo Chinês. Além disso, na terça-feira, a empresa disponibilizou seu modelo visual, Qwen 2.5-VL, como código aberto. No mesmo dia, a Alibaba também forneceu suporte de computação em nuvem para a transmissão ao vivo da Gala do Festival da Primavera, o tradicional programa anual que mistura música, dança, ópera, artes marciais e comédia, assistido por bilhões de pessoas. “Qwen 2.5-Max supera quase em todos os aspectos o GPT-4o, o DeepSeek-V3 e o Llama-3.1-405B”, afirmou a unidade de nuvem da Alibaba em um comunicado publicado em sua conta oficial no WeChat, referindo-se aos modelos avançados de IA da OpenAI e da Meta. O lançamento do assistente de IA da DeepSeek, em 10 de janeiro, alimentado pelo modelo DeepSeek-V3, bem como a recente introdução do modelo R1, causou impacto no Vale do Silício e levou a uma queda nas ações de empresas de tecnologia. O suposto baixo custo de desenvolvimento e uso da tecnologia da startup chinesa fez com que investidores questionassem os elevados gastos das principais empresas de IA dos Estados Unidos. O sucesso da DeepSeek desencadeou uma corrida entre suas concorrentes chinesas para atualizar seus próprios modelos de inteligência artificial. Dois dias após o lançamento do DeepSeek-R1, a ByteDance, dona do TikTok, anunciou uma atualização de seu modelo de IA principal, alegando que ele superou o modelo o1, da OpenAI, apoiada pela Microsoft, no AIME, um teste de benchmark que avalia a capacidade dos modelos de IA de compreender e responder a instruções complexas. Essa afirmação ecoa a da DeepSeek, que declarou que seu modelo R1 rivaliza o modelo o1 da OpenAI em vários testes de desempenho. Tradução: Mei Zhen Li Fonte: Sina
27 de janeiro de 2025
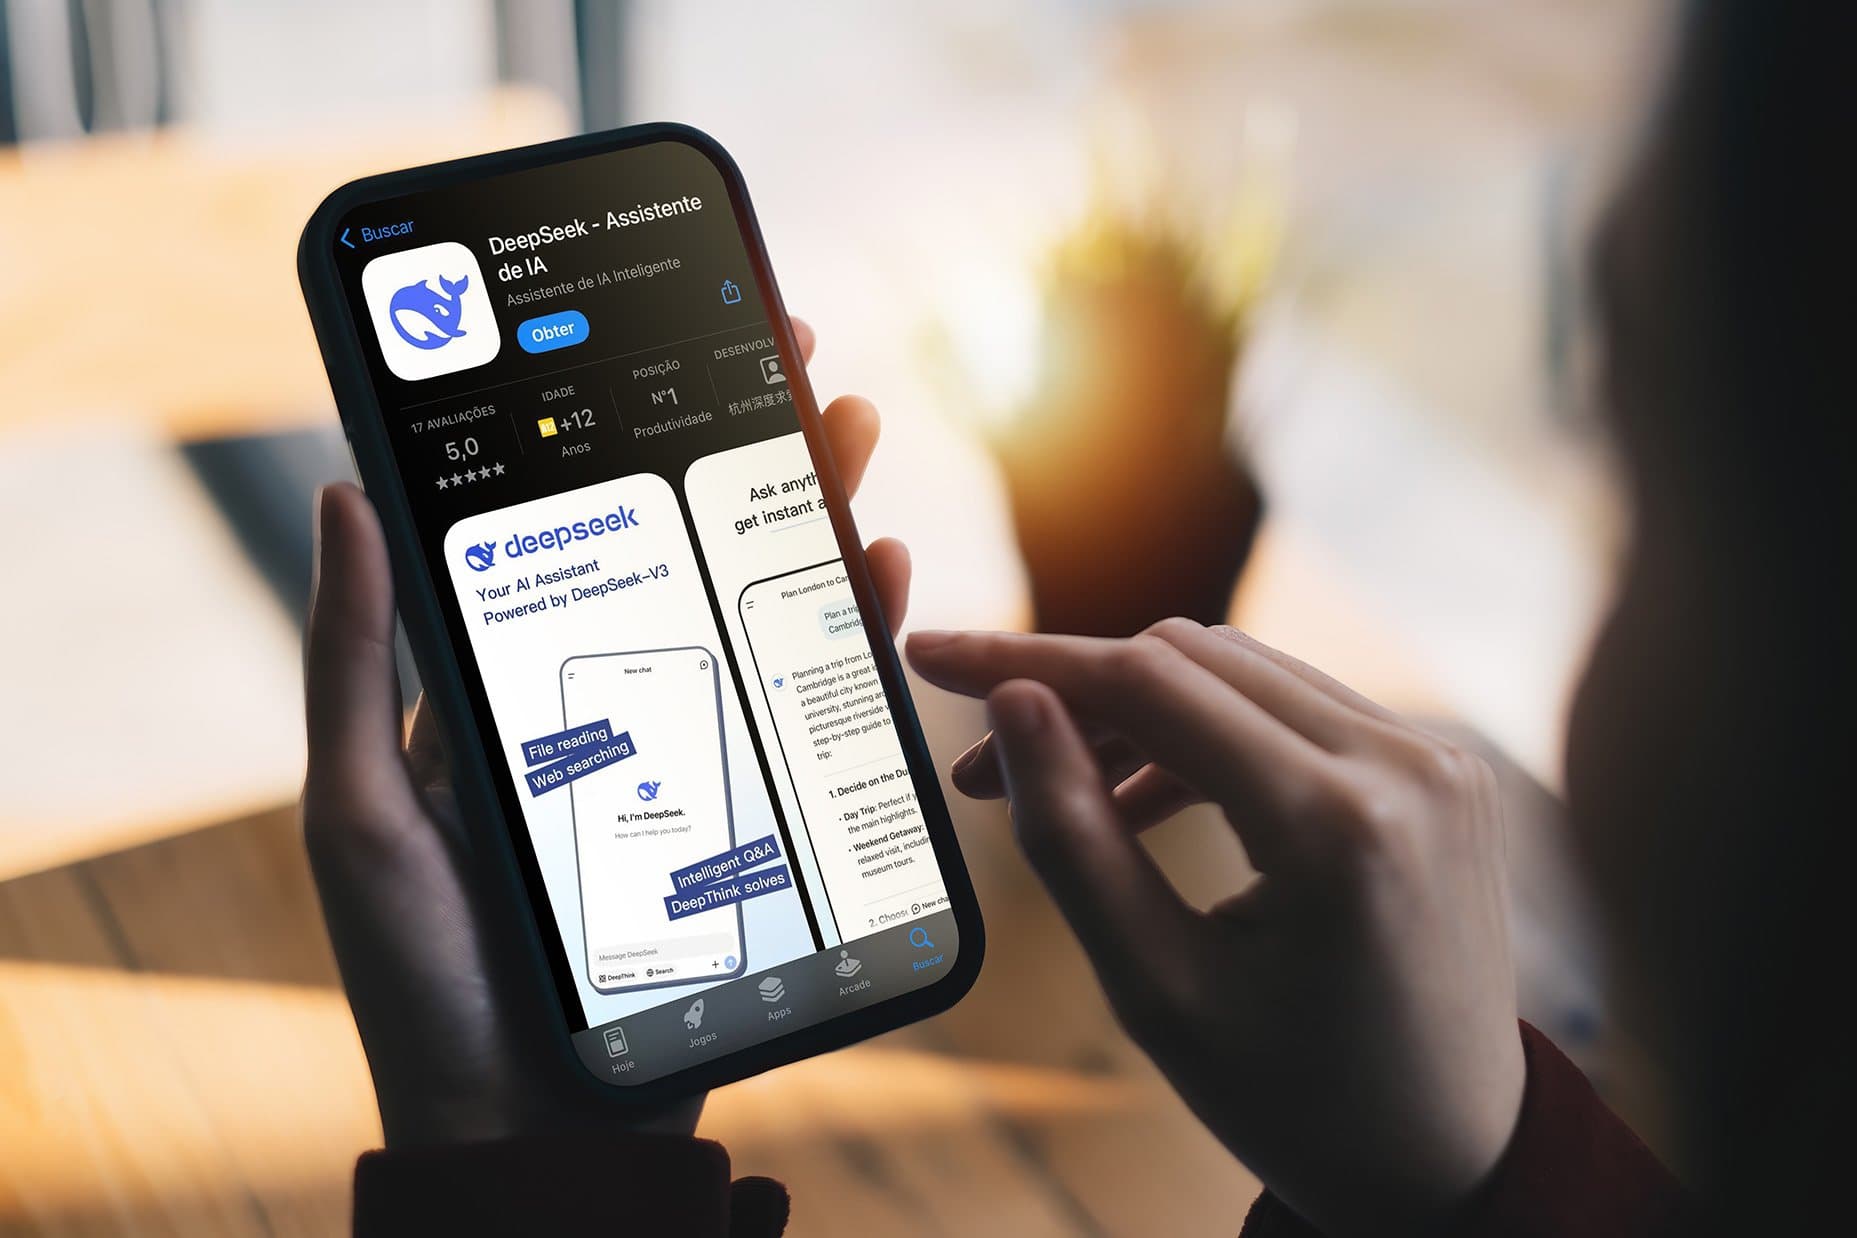
O aplicativo de IA chinês DeepSeek superou o ChatGPT , da OpenAI, alcançando o primeiro lugar entre os aplicativos gratuitos para iPhone, tanto na China quanto nos EUA. Esse marco foi alcançado poucos dias após a desenvolvedora chinesa lançar o "modelo de raciocínio", DeepSeek R1. Ao ativar o modo "DeepThink (R1)", o aplicativo exibe seu "processo de pensamento" antes de gerar respostas, permitindo resolver problemas complexos de lógica e matemática. Segundo o site oficial, o desempenho do modelo R1 é "comparável" ao OpenAI-o1, mas com um custo operacional 30 vezes menor. A DeepSeek publicou um artigo técnico detalhando o desenvolvimento do modelo R1, permitindo que outros desenvolvedores repliquem o processo utilizando seus próprios dados de treinamento. O chatbot web oferece uso gratuito para o público geral, cobrando apenas pelas chamadas de API. Os usuários podem baixar gratuitamente o modelo completo para executá-lo localmente, com versões otimizadas para uma ampla gama de dispositivos, desde laptops ultrafinos até PCs de alto desempenho. A perspectiva do CEO da DeepSeek Em entrevista ao portal de notícias chinês, 36kr.com, o CEO da DeepSeek, Liang Wenfeng enfatizou a necessidade de a China se posicionar como inovadora global, indo além do estereótipo de aplicar inovações americanas. Liang destacou que a equipe da DeepSeek é composta por jovens talentos, sem contribuições diretas de chineses do exterior, e defendeu a importância de cultivar talentos locais. "Os 50 principais talentos da área podem não estar na China, mas podemos desenvolver os nossos próprios", disse Liang. Reações da Comunidade de IA O lançamento do modelo R1 gerou grande impacto na indústria de IA, recebendo elogios de figuras como Marc Andreessen, cofundador da Netscape, descreveu o R1 como "um dos avanços mais incríveis" que já viu. Jim Fan, gerente de pesquisa da Nvidia, observou que a DeepSeek está mantendo viva a missão de "pesquisa aberta e de ponta". Yann LeCun, cientista-chefe de IA da Meta, afirmou que o sucesso da DeepSeek destaca o poder dos modelos de código aberto sobre os proprietários. Kai-Fu Lee, ex-presidente do Google China, afirmou que o DeepSeek valida o potencial da China em engenharia de IA generativa. E Aravind Srinivas, CEO da Perplexity, destacou que a DeepSeek "replicou amplamente o OpenAI-o1-mini e o open-source". Tradução: Mei Zhen Li Fonte: The Paper
11 de junho de 2024
O Apple Vision Pro começará a receber pré-encomendas em 13 de junho na China continental, onde o fone de ouvido de realidade mista da Apple está com preços de 16% a 18% mais altos do que nos Estados Unidos. As versões de 256 gigabytes, 512 GB e 1 terabyte são precificadas a partir de 29.999 de yuans (US$ 4.135), 31.499 de yuans (US$ 4.345) e 32.999 de yuans (US$ 4.550) respectivamente na China, em comparação com US$ 3.499, US$ 3.699 e US$ 3.899 no mercado dos EUA, de acordo com o site da Apple. O Vision Pro estará disponível em novos mercados, incluindo a China continental, Hong Kong, Japão e Singapura, em 28 de junho, anunciou a Apple na Worldwide Developers Conference ontem. O dispositivo será lançado na Austrália, Canadá, França, Alemanha e Reino Unido em 28 de junho e estará disponível a partir de 12 de julho. A Apple também revelou seu visionOS 2. Disponível como uma atualização gratuita de software neste outono, o visionOS 2 inclui uma variedade de novos recursos, incluindo uma maneira de transformar fotos em memórias tridimensionais, gestos intuitivos para acessar facilmente a Home View e informações importantes de relance. O Vision Pro agora conta com mais de 2.000 aplicativos dedicados e 1,5 milhão de aplicativos compatíveis com iPhone e iPad, observou a Apple. As remessas do Vision Pro devem atingir entre 400.000 e 450.000 unidades este ano, disse Ming-Chi Kuo, analista da TF International Securities. A chave para o sucesso do fone de ouvido está em seu ecossistema, incluindo sua capacidade de integração com outros produtos Apple, acrescentou. A inteligência artificial generativa foi outro foco principal do evento de ontem. A Apple introduziu um sistema de inteligência pessoal para iPhone, iPad e Mac que combina o poder dos modelos de IA generativa com recursos personalizados, que estarão disponíveis em seu próximo sistema operacional móvel, o iOS 18 . A Apple também anunciou que chegou a um acordo com a OpenAI , a empresa por trás do ChatGPT, para trazer seu modelo de linguagem grande para os produtos da Apple ainda este ano. Tradução: Mei Zhen Li Fonte: Yicai Global Imagem principal: Apple/ Divulgação

15 de março de 2024
No mundo da inteligência artificial, onde cada avanço representa um passo rumo à próxima geração de tecnologia, a empresa de semicondutores Cerebras Systems, impulsionada pelo investimento do fundador da OpenAI, Sam Altman, lançou um desafio direto à gigante NVIDIA com seu mais recente chip Wafer Scale Engine 3 (WSE-3). Este chip, com uma área impressionante de 46.225 milímetros quadrados, supera em mais de 50 vezes o tamanho dos chips convencionais e até mesmo rivaliza com o tamanho de um livro. O WSE-3 é projetado para lidar com os maiores modelos de inteligência artificial da indústria, incorporando uma impressionante quantidade de 40 trilhões de transistores e 900.000 núcleos de IA, tudo isso fabricado com a avançada tecnologia de processo de 5 nanômetros da TSMC. Em comparação, o chip H100 da NVIDIA, com "meros" 80 bilhões de transistores, fica à sombra da magnitude do WSE-3. A Cerebras Systems não apenas introduziu um novo chip, mas também lançou um desafio direto à NVIDIA ao afirmar que o desempenho do WSE-3 é oito vezes superior ao do H100 em termos de aceleração de treinamento de inteligência artificial. A empresa destacou a facilidade de uso de sua plataforma em comparação com a da NVIDIA, enfatizando que a integração e escalabilidade do WSE-3 superam qualquer alternativa disponível atualmente. O investimento da OpenAI na Cerebras Systems não é apenas um apoio financeiro, mas também uma demonstração de confiança na visão e na tecnologia da empresa. Com investidores de peso, como Sam Altman, o ex-CTO da AMD Fred Weber e várias outras instituições de destaque, a Cerebras Systems está posicionada como uma força disruptiva no mercado de semicondutores de inteligência artificial. A estratégia da Cerebras Systems de produzir chips "enormes" não é novidade na indústria. Desde o lançamento do Wafer Scale Engine (WSE) em 2019, com 1,2 trilhão de transistores e 400 mil núcleos de IA, até o recente WSE-3, a empresa vem desafiando as convenções ao optar por transformar um wafer inteiro em um único chip, em vez de cortá-lo em várias unidades menores. Esta abordagem resulta em uma área de chip única que rivaliza com a de um wafer de 12 polegadas. Apesar do interesse inicial demonstrado pelo mercado, os desafios enfrentados pela Cerebras Systems ainda são significativos. Embora a empresa tenha acumulado uma quantidade considerável de pedidos de empresas, governos e provedores de nuvem, sua abordagem não convencional e seus chips de grande porte podem não ser a solução ideal para as demandas do mercado mainstream. Questões como consumo de energia, infraestrutura de hardware e compatibilidade com software devem ser consideradas ao implantar esses chips em data centers e ambientes corporativos. Enquanto a Cerebras Systems continua a desafiar o status quo com sua abordagem inovadora e seus chips gigantes, o mercado aguarda para ver se esses gigantes serão abraçados ou simplesmente ignorados em favor de soluções mais convencionais. Ainda assim, o investimento da OpenAI e o crescimento contínuo da Cerebras Systems destacam o potencial disruptivo desta empresa no cenário tecnológico em constante evolução. Tradução: Mei Zhen Li Fonte:Yicai Global Imagem principal: Amazing studio/ Adobe Stock
13 de dezembro de 2023
O gigante chinês Alibaba está levando seu grande modelo de Inteligência Artificial para o Sudeste Asiático, buscando uma presença mais forte no mercado da região. O laboratório de pesquisa da Alibaba, conhecido como Damo Academy, lançou recentemente a primeira versão de seu grande modelo de linguagem de IA chamado SeaLLM, treinado em idiomas do Sudeste Asiático, além de um chatbot chamado SeaLLM-chat. Este modelo inclui duas versões diferentes com 13 bilhões e 7 bilhões de parâmetros, capazes de lidar com idiomas como vietnamita, indonésio, tailandês, malaio, khmer, lao, tagalo e birmanês. Segundo o Alibaba, a introdução desse modelo para o Sudeste Asiático é uma resposta ao crescente interesse na região por grandes modelos de IA. A empresa busca criar modelos de IA mais inclusivos e culturalmente relevantes, refletindo as sutilezas culturais do Sudeste Asiático. Até agora, a maioria dos grandes modelos de IA na região do Sudeste Asiático provém de países ocidentais, treinados principalmente em inglês ou outras línguas latinas. O SeaLLM realiza treinamento em várias línguas do Sudeste Asiático, com especial atenção para línguas não latinas. O modelo tem capacidades aprimoradas para tarefas mais complexas, destacando-se em disciplinas como ciência, química, física e economia quando comparado à maioria dos grandes modelos de código aberto. A Alibaba afirma que esse modelo inovador acelerará a adoção da inteligência artificial, proporcionando suporte às comunidades historicamente sub-representadas no domínio digital. A Alibaba colaborou extensivamente com a Universidade Tecnológica de Nanyang (NTU) em pesquisa de inteligência artificial multilíngue. O lançamento do SeaLLM pode criar novas oportunidades para milhões de pessoas que falam idiomas além do inglês e chinês, além de auxiliar as empresas a se envolverem mais profundamente no mercado do Sudeste Asiático, construindo assistentes de chatbot próprios. Esta iniciativa da Alibaba segue a tendência de empresas chinesas expandindo suas operações para o Sudeste Asiático. A Alibaba Cloud, braço de computação em nuvem da Alibaba, já estabeleceu data centers em Singapura, Indonésia, Filipinas, Malásia e Tailândia para atender à crescente demanda na região. A competição no mercado de grandes modelos no Sudeste Asiático está aumentando, com empresas chinesas, locais e também organizações globais, como a OpenAI, buscando uma presença significativa. A estratégia da Alibaba parece refletir a importância crescente do Sudeste Asiático no cenário global de tecnologia e comércio eletrônico, onde a empresa está competindo ativamente com outras potências tecnológicas para estabelecer sua presença. Fonte: yicai.com Imagem principal: Ju Huanzong/ Xinhua