11 de fevereiro de 2026
O Seedance 2.0, novo modelo de geração de vídeo por inteligência artificial da ByteDance , entrou em testes limitados no início de 2026 e passou a atrair atenção global pelo nível de controle sobre cenas, personagens e movimentos de câmera. O lançamento em fase de testes ocorreu em 7 de fevereiro. A repercussão entre criadores e investidores se refletiu no mercado financeiro chinês nos dias 9 e 10 de fevereiro. O sistema gera vídeos com múltiplos planos a partir de texto e referências visuais e sonoras. O modelo aceita quadros iniciais e finais, clipes de vídeo e áudio como referência e permite editar partes específicas do material após a geração. Segundo relatórios da Open Source Securities, a ferramenta automatiza movimentos de câmera e divisão de cenas. Além disso, o sistema gera vídeos a partir de storyboards e mantém consistência de personagens, iluminação e estilo entre diferentes planos. O modelo aceita até 12 arquivos de referência, como imagens, vídeos e áudios. Com isso, a IA aprende composição visual, características de personagens e linguagem cinematográfica sem exigir comandos extensos. Criadores relatam melhora na transição entre cenas e na coerência dos personagens. Um produtor afirmou que os modelos passaram a lidar com consistência visual e regras físicas básicas, o que alterou o resultado final dos vídeos. Após testar o Seedance 2.0, Feng Ji, CEO da Game Science e produtor de Black Myth: Wukong, afirmou que o modelo marca uma nova etapa do conteúdo gerado por IA. Nas redes sociais, o criador de conteúdo “el.cine” disse que o sistema elevou o nível de exigência para profissionais do audiovisual e passou a ser usado por cineastas independentes na China em projetos experimentais. Como o Seedance 2.0 segue em testes, a ByteDance não divulgou preços. Em junho de 2025, o Seedance 1.0 Pro custava RMB 0,01 por mil tokens, e um vídeo de 5 segundos em 1080p saía por RMB 3,67. Criadores informam que, em modelos disponíveis no mercado, um vídeo de 3 segundos em 480p custa cerca de RMB 0,30 e, em 720p, quase RMB 1. O uso de modelos de vídeo por IA cresce e já aparece entre os mais adotados após os modelos de linguagem. O avanço do Seedance 2.0 ocorre em um ambiente de disputa global. No exterior, Sora, da OpenAI, e os modelos da Runway avançam na geração de vídeo. Na China, Kling, da Kuaishou, Vidu, da Shengshu Technology, e Hailuo, da MiniMax, disputam aplicações como vídeos longos e consistência de personagens. Em 2026, a xAI lançou o Grok Imagin 1.0, com geração de vídeos de até 10 segundos em 720p. A Shengshu lançou o Vidu Q3, voltado a séries curtas, e alcançou o segundo lugar em rankings da Artificial Analysis. A Kuaishou apresentou o Kling 3.0, que cobre etapas da produção audiovisual. Até dezembro de 2025, o Kling reunia mais de 60 milhões de criadores, com 600 milhões de vídeos gerados e receita anualizada de US$ 240 milhões. A Runway lançou o Gen-4.5, com foco em narrativa imagem-vídeo, e testes indicaram dificuldade de distinção entre vídeos gerados e reais. Apesar do avanço técnico, surgiram alertas sobre uso de dados. Usuários relataram que o modelo gera vozes semelhantes a partir de uma única imagem e cria ângulos não presentes no material original. Em 9 de fevereiro, a ByteDance anunciou que o Seedance 2.0 suspenderia temporariamente o uso de imagens e vídeos de pessoas reais como referência principal. Para o professor Sha Lei, da Universidade Beihang, o avanço da IA exige equilíbrio entre inovação, conformidade de dados e proteção de direitos autorais. Zhang Libo, do Instituto de Software da Academia Chinesa de Ciências, afirmou que o uso de dados públicos é comum no setor, mas áudio e vídeo ampliam riscos por envolverem identificação pessoal. Especialistas avaliam que não existe um único modelo dominante. Segundo Wang Chao, fundador do Wenyuan Think Tank, o desempenho varia conforme o cenário de uso. Para Kang Zhuoliang, pesquisador do LongCat-Video, da Meituan, a evolução dos modelos aponta para aplicações além da criação de conteúdo, com uso em simulação de ambientes físicos, robótica e sistemas de direção autônoma. Fonte: sina.com.cn
16 de dezembro de 2025
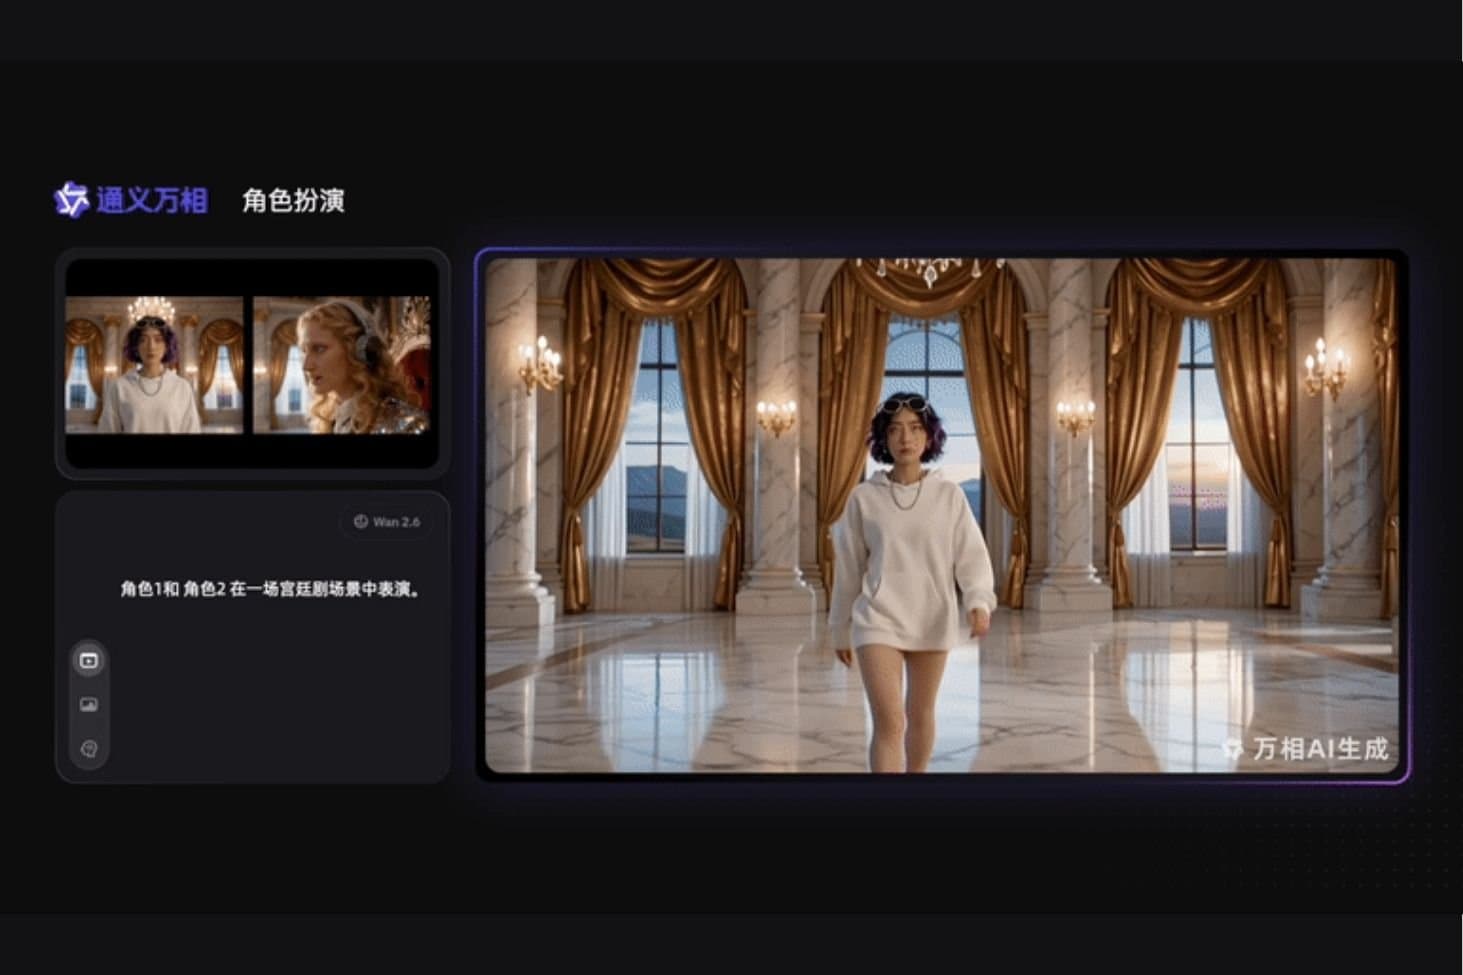
A Alibaba lançou, em 16 de dezembro, a nova geração da série de modelos de inteligência artificial Wanxiang 2.6, voltada à produção audiovisual profissional e à criação de imagens. O modelo passa a oferecer, pela primeira vez na China, suporte à interpretação de personagens em vídeos gerados por IA. A atualização também inclui sincronização entre áudio e imagem, geração de múltiplas cenas e condução por voz. O Wanxiang 2.6 já está disponível no Alibaba Cloud Bailian e no site oficial da plataforma. O lançamento ocorre após a Alibaba apresentar, em setembro, o Wanxiang 2.5, primeiro modelo chinês de geração de vídeo com sincronização audiovisual. Segundo a empresa, essa versão elevou a eficiência da criação de vídeos. No ranking do LMArena , que avalia grandes modelos de IA, o Wanxiang liderou a classificação nacional em geração de vídeo a partir de imagens. A versão 2.6 amplia a qualidade de imagem, os efeitos sonoros e a precisão no cumprimento de instruções. Cada vídeo pode ter até 15 segundos de duração, o maior limite registrado no mercado chinês até o momento. O modelo incorpora recursos de interpretação de personagens e controle de storyboard, o que permite gerar vídeos com uma ou várias pessoas, além de interações entre pessoas e objetos. O sistema também realiza automaticamente a alternância entre cenas, atendendo a demandas de produções audiovisuais profissionais. De acordo com a Alibaba, o Tongyi Wanxiang utiliza uma arquitetura multimodal que integra vídeos de referência no processo de aprendizado. O modelo analisa emoções, posturas e características visuais dos personagens ao longo do tempo e em diferentes ângulos. Também extrai dados acústicos, como timbre e velocidade da fala. Essas informações funcionam como parâmetros de controle na geração dos vídeos, garantindo consistência entre imagem e som. Atualmente, o sistema já suporta performances individuais e em grupo. No controle de storyboard, o modelo aplica compreensão semântica avançada para dividir os comandos do usuário em múltiplas cenas, com narrativa estruturada. Durante as transições, o sistema mantém a consistência do personagem principal, do cenário e da atmosfera, o que assegura uniformidade de ritmo e estilo ao longo do vídeo. O recurso de interpretação de personagens amplia o uso do modelo por usuários não especializados. Ao enviar um vídeo pessoal e definir um prompt, como ficção científica ou suspense, o sistema cria automaticamente o storyboard, a atuação do personagem e a dublagem, gerando um curta com narrativa completa e movimentos de câmera inspirados no cinema. Em aplicações profissionais, como publicidade e produção de minisséries, o Wanxiang 2.6 permite gerar vídeos completos a partir de prompts contínuos. Segundo a empresa, o modelo mantém a consistência de personagens, produtos e cenários mesmo com múltiplas mudanças de cena, o que facilita a criação de campanhas publicitárias e conteúdos seriados. O acesso ao Wanxiang 2.6 já está disponível para usuários no site oficial da plataforma. Empresas podem utilizar a API por meio do Alibaba Cloud Bailian. A Alibaba também informou que o aplicativo Qwen deverá integrar o modelo em breve. Atualmente, a família Wanxiang reúne mais de dez capacidades de criação visual, incluindo geração e edição de imagens, geração de vídeos a partir de texto, imagens ou voz, criação de movimentos, interpretação de personagens e edição geral de vídeos. Esses recursos já são utilizados em áreas como quadrinhos animados com IA, design publicitário e produção de vídeos curtos. Fonte: tmtpost.com